Mis à jour le 6 octobre 2026 par l'Équipe de broker-forex.fr
La théorie des probabilités est essentielle en matière de trading et d'investissement, car elle permet aux acteurs du marché de comprendre et de quantifier l'incertitude et le risque associés à leurs décisions financières.
Comme la vie elle-même, le trading est une question de probabilités. Il existe rarement des résultats évidents, en noir et blanc, sur lesquels il serait facile de capitaliser. En utilisant la théorie des probabilités, les traders et les investisseurs peuvent prendre des décisions plus éclairées sur la base de la probabilité de divers résultats.
Points clés à retenir
Voici les principales raisons pour lesquelles la théorie des probabilités occupe une place aussi centrale dans le trading et l'investissement.
La théorie des probabilités permet aux investisseurs de calculer la probabilité que divers événements se produisent, qu'il s'agisse de scénarios positifs ou négatifs. Cela aide les traders à mieux comprendre les risques potentiels associés à différentes transactions ou différents investissements.
Elle permet aux traders de prendre de meilleures décisions en se fondant sur la probabilité de différents résultats et en évaluant la fiabilité de ces probabilités elles-mêmes (ce que l'on pourrait appeler des « probabilités de probabilités », car les chances que différentes choses se produisent ne sont pas connues avec certitude).
Par exemple, si une transaction a une probabilité de 70 % de produire un rendement positif sur un an, comment le savez-vous réellement ? La théorie des probabilités couvre des aspects tels que la variance et la manière de gérer ce que l'on ne sait pas et ne peut pas savoir.
Elle aide les traders et investisseurs à gérer leurs portefeuilles en fournissant un moyen d'évaluer le risque associé à différentes classes d'actifs. En analysant la probabilité de différents résultats, ils peuvent construire un portefeuille diversifié qui équilibre le risque et le rendement.
La théorie des probabilités est également au cœur de la gestion des risques, car elle aide à déterminer la probabilité d'événements susceptibles d'avoir un impact négatif sur les positions et à prendre des mesures pour les atténuer.
Dans l'ensemble, la théorie des probabilités est un outil indispensable pour comprendre les risques et les bénéfices potentiels de différentes opportunités, faire des choix plus éclairés et obtenir de meilleurs résultats sur le long terme. Dans cet article, nous examinons les principales branches de la théorie des probabilités et leurs applications concrètes dans le domaine du trading.

En théorie des probabilités, le caractère aléatoire fait référence au fait que l'issue d'un événement est imprévisible et peut varier d'un essai à l'autre. Ce phénomène est souvent modélisé à l'aide de distributions de probabilité, qui décrivent la probabilité de chaque résultat possible.
L'aléatoire est un concept fondamental, car il nous permet de quantifier l'inconnu et de faire des prédictions sur l'avenir à partir d'informations incomplètes. Dans de nombreuses situations réelles, les résultats sont affectés par un grand nombre de variables qu'il est difficile, voire impossible, de prévoir avec précision.
Dans le domaine du trading, le hasard est omniprésent : les marchés financiers sont soumis à un large éventail d'influences. Il existe de nombreux types d'intervenants, de tailles différentes et aux motivations divergentes. Le caractère aléatoire peut se manifester sous la forme de la volatilité du marché, d'événements inattendus ou d'autres facteurs provoquant des fluctuations rapides et imprévisibles des prix.
Comprendre et prendre en compte ce caractère aléatoire est essentiel pour élaborer des stratégies de trading fructueuses et gérer les risques. Plus un trader acquiert d'expérience, plus il réalise que ce qu'il sait reste modeste au regard de tout ce qu'il faudrait savoir compte tenu de ce qui est déjà actualisé dans les prix.
L'une des façons de gérer le hasard consiste à utiliser des modèles fondés sur les probabilités. Par exemple, un trader peut recourir à un modèle statistique pour estimer la probabilité d'une hausse ou d'une baisse du prix d'un actif sur une période donnée, puis utiliser cette information pour constituer un portefeuille équilibré et gérer le risque.
Par exemple, si la distribution des prix actualisés d'un actif ressemble à ceci :
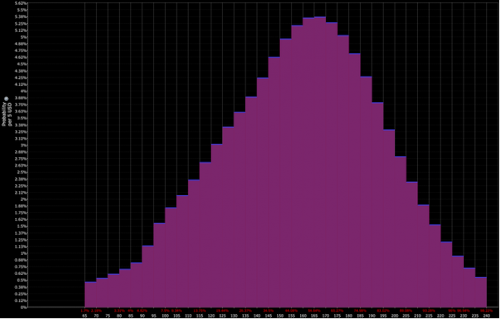
Et que l'interprétation du trader se rapproche plutôt de la combinaison des distributions rouge et violette (c'est-à-dire une inclinaison baissière) :
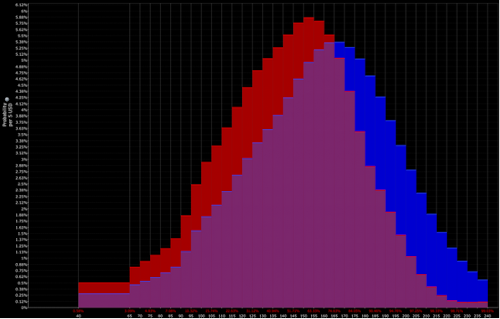
Il peut alors envisager une position baissière sur l'actif. Reste ensuite la question, tout aussi importante, de la mise en place de la position et de son dimensionnement.
En théorie des probabilités, le concept d'exclusivité mutuelle désigne la propriété de deux événements qui ne peuvent pas se produire en même temps. Mathématiquement, deux événements A et B sont mutuellement exclusifs si leur intersection est vide, c'est-à-dire que P(A ∩ B) = 0.
L'exclusivité mutuelle est importante en trading, car elle aide les investisseurs à mieux gérer leurs risques. Lorsqu'ils détiennent un portefeuille d'actifs, ils doivent tenir compte des corrélations entre eux.
Par exemple, supposons qu'un investisseur possède un portefeuille comprenant à la fois des valeurs technologiques et des compagnies pétrolières. Si le prix du pétrole augmente, cela peut favoriser les pétrolières mais peser sur les valeurs technologiques (notamment via l'effet de la hausse des prix sur les taux d'intérêt), et inversement. Pourtant, certains développements propres à chaque secteur peuvent n'avoir aucune influence sur les titres de l'autre.
Ainsi, même si des titres sont liés à certains égards, comme les variations de la croissance actualisée ou de l'inflation, ils peuvent à d'autres égards s'exclure mutuellement. Comment ces facteurs sont-ils séparés ? Parfois par la nature même du flux financier (le pétrole face aux produits technologiques) ; parfois on les regroupe sous forme de facteurs (momentum, taille, qualité, valeur, etc.).
L'exclusivité mutuelle est par ailleurs centrale dans le trading des options, où le gain d'une option dépend souvent de la non-occurrence d'un autre événement. Dans ce contexte, elle aide les opérateurs à couvrir leurs risques et à gérer leur exposition.
Une expérience ou essai de Bernoulli est un concept fondamental qui désigne un événement aléatoire avec seulement deux résultats possibles. Le lancer d'une pièce de monnaie en est l'exemple typique, avec pile ou face. Autre exemple : savoir si une option finira dans le cours ou hors du cours à l'expiration.
La probabilité de réussite (l'issue qui nous intéresse) est notée p, et la probabilité d'échec q = 1 − p. Les résultats sont souvent codés 1 pour le succès et 0 pour l'échec.
L'importance des essais de Bernoulli en trading tient au fait que de nombreuses décisions impliquent des résultats binaires. Par exemple, vous pouvez acheter une option d'achat en espérant qu'elle dépasse le seuil de rentabilité, ou la vendre en espérant encaisser la prime. Dans les deux cas, le résultat est binaire en termes de gain. Les paris binaires purs prennent d'ailleurs la forme d'options binaires.
En appliquant ces principes, vous pouvez décider plus rationnellement du moment d'acheter ou de vendre. Des concepts comme la valeur attendue rappellent par ailleurs qu'il ne faut pas toujours parier sur le résultat le plus probable.
Une distribution de probabilité est une fonction qui décrit la probabilité des différents résultats d'une expérience aléatoire. Elle spécifie les probabilités de toutes les issues possibles, et la somme de ces probabilités est égale à un.
Il existe de nombreux types de distributions, parmi lesquelles les plus courantes sont la distribution normale, la distribution binomiale et la distribution de Poisson. Chacune possède ses propres paramètres qui déterminent sa forme. Sur les marchés financiers, les rendements présentent toutefois des queues plus épaisses que la loi normale et ne correspondent pas exactement à une distribution standard ; ils sont donc souvent personnalisés.
L'un des concepts les plus importants en trading est que tout est une probabilité, c'est-à-dire une distribution de résultats potentiels. Il n'existe pas d'issue unique particulièrement probable.
En utilisant des distributions de probabilité, les traders peuvent estimer la probabilité de différents résultats et mieux allouer leurs ressources. Par exemple, un trader peut modéliser les rendements quotidiens d'une action avec une distribution à queues épaisses, puis estimer la probabilité que le rendement dépasse un certain seuil (par exemple ±5 % en une journée).
Au-delà de l'estimation des probabilités, les distributions servent aussi à valoriser des instruments financiers comme les options et les contrats à terme. Ces instruments sont valorisés en fonction de la distribution sous-jacente de l'actif auquel ils sont liés, et les traders les utilisent pour couvrir leur risque ou prendre position sur les mouvements futurs.
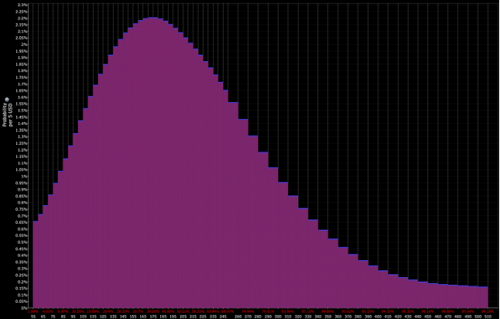
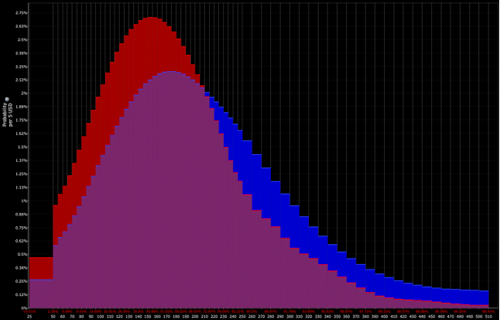
Distribution telle qu'actualisée par les marchés :
Distribution déterminée par le trader (ce qui ouvre la porte à des opportunités tactiques) :
La distribution binomiale modélise le nombre d'issues positives dans une série d'essais indépendants et identiques, où chaque essai n'a que deux résultats possibles (pile ou face, gagnant ou perdant, hausse ou baisse). Ses paramètres clés sont la probabilité de réussite d'un essai (p) et le nombre d'essais (n).
Elle est utile en trading, car elle permet de modéliser la distribution des rendements d'une stratégie binaire (acheter ou vendre selon qu'un événement se produit ou non). La valeur attendue d'une telle stratégie est la somme des produits de la probabilité de chaque résultat par le gain correspondant.
Par exemple, si une stratégie binaire a une probabilité de 60 % de réaliser un rendement de 10 % et de 40 % de réaliser un rendement de -5 %, sa valeur attendue est :
(0,6 × 0,1) + (0,4 × (-0,05)) = +0,04
La distribution binomiale permet aussi de calculer la probabilité de chaque taux de réussite possible sur une série de transactions. Si un trader effectue 10 transactions binaires avec 60 % de réussite, il peut estimer la probabilité d'obtenir tel ou tel nombre de gains, et donc évaluer le risque et le rendement de sa stratégie.
Nous avons abordé la valeur attendue (VA) dans d'autres articles, car il s'agit d'un concept fondamental qui décrit le résultat moyen d'une variable aléatoire. En trading, elle sert à calculer le rendement et le risque potentiels d'un investissement ou d'une stratégie.
Mathématiquement, la valeur attendue est la somme des produits de chaque résultat possible par sa probabilité. Prenons un tirage à pile ou face qui rapporte 1 $ pour pile et 0 $ pour face :
VA = (0,5 × 1 $) + (0,5 × 0 $) = 0,50 $
Le gain moyen de ce jeu est donc de 0,50 $. À long terme, vous atteindrez le seuil de rentabilité si vos chances correspondent à la probabilité réelle.
Pour un investissement, si une action a 60 % de chances de progresser de 10 % et 40 % de chances de reculer de 5 %, le rendement attendu est :
VA = (0,6 × 10 %) + (0,4 × -5 %) = 6 % − 2 % = 4 %
Le rendement attendu est donc de 4 %. La valeur attendue est aussi essentielle en gestion du risque : si la VA d'un investissement est négative, il est susceptible de perdre de l'argent en moyenne sur le long terme. Les traders peuvent alors diversifier ou limiter leur exposition.
Point crucial : parier sur le résultat à la valeur attendue la plus élevée n'est pas toujours la meilleure décision. Il est parfois préférable d'accepter une VA plus faible si cela réduit la variance (donc le risque de perte). Vous devez aussi toujours pouvoir couvrir la perte.
Par exemple, avec 1 000 $, si vous avez 90 % de chances de doubler à 2 000 $ et 10 % de tout perdre, votre VA est très élevée (1 800 $ − 1 000 $ = +800 $). Mais si vous ne pouvez pas vous permettre de perdre ces 1 000 $, mieux vaut s'abstenir.
La chaîne de Markov décrit un processus dans lequel l'état suivant dépend uniquement de l'état actuel, et non des états précédents. Il s'agit d'un processus « sans mémoire ». Elle est définie par un ensemble d'états et par les probabilités de passer d'un état à un autre, souvent représentées dans une matrice de transition.
En trading, la chaîne de Markov peut servir à modéliser le comportement des marchés. Le marché boursier est un système complexe avec un grand nombre de variables ; la chaîne de Markov le simplifie en se concentrant sur l'état actuel et les probabilités de transition.
En modélisant le marché ainsi, les traders peuvent tenter de prédire les mouvements futurs à partir de l'état présent et de calculer des mesures comme les rendements attendus, la volatilité et le risque. La chaîne de Markov intervient également dans diverses techniques de modélisation financière : évaluation des options, optimisation de portefeuille, gestion des risques et test de stratégies dans différentes conditions de marché.
La marche aléatoire décrit le mouvement d'un objet de manière aléatoire et imprévisible : sa prochaine position est déterminée par un processus aléatoire, comme un tirage au sort. En finance, ce modèle est souvent utilisé pour décrire l'évolution du cours des actions dans le temps.
La théorie sous-jacente est que les mouvements de prix sont imprévisibles et suivent un schéma aléatoire : à un instant donné, le prix d'une action a autant de chances de monter que de descendre, indépendamment des prix passés (même s'il existe diverses théories sur les tendances et le momentum).
Ce concept est utile, car il suggère qu'il est très difficile de prédire les cours et donc de battre constamment le marché en s'appuyant uniquement sur les mouvements passés. Les investisseurs peuvent en tirer des enseignements : privilégier un portefeuille diversifié (par actifs, classes d'actifs, pays et devises) afin de réduire l'exposition aux mouvements individuels, et envisager une stratégie d'achat-conservation pour éviter les coûts et risques des transactions fréquentes.
Un processus stochastique est un cadre mathématique servant à modéliser un système qui évolue de manière aléatoire dans le temps. Il s'agit d'une collection de variables aléatoires indexées par le temps : la valeur du processus à un instant donné est aléatoire.
Ces processus permettent d'analyser le comportement de phénomènes aléatoires évoluant dans le temps, de modéliser leur caractère imprévisible et de faire des prédictions fondées sur les résultats attendus.
En trading, ils servent à modéliser certains comportements des marchés et des prix d'actifs, à analyser le caractère aléatoire et la volatilité des données financières, et à décider du moment d'acheter ou de vendre. Par exemple, ils peuvent modéliser l'évolution des cours d'actions ou des taux de change. Ils sont également précieux pour développer et tester des stratégies : en simulant le comportement des marchés, les traders évaluent les performances de leurs stratégies dans différentes conditions.
La probabilité conditionnelle désigne la probabilité qu'un événement se produise sachant qu'un autre événement s'est déjà produit. C'est un moyen d'actualiser nos estimations à la lumière d'informations nouvelles. Formellement, la probabilité conditionnelle de A sachant B se définit ainsi :
P(A | B) = P(A et B) / P(B)
Où :
Elle est importante en trading, car elle permet d'actualiser nos probabilités au fur et à mesure que l'information arrive. Par exemple, si une entreprise publie un excellent rapport de résultats, la probabilité conditionnelle que son cours monte, compte tenu de cette information, est plus élevée qu'avant l'annonce.
Les investisseurs utilisent ce concept pour mieux évaluer les risques et les bénéfices, réaliser des transactions plus rentables et gérer leur risque plus efficacement. Pour une action historiquement volatile, par exemple, la probabilité conditionnelle permet d'estimer la probabilité d'une hausse ou d'une baisse selon diverses conditions de marché : taux d'intérêt, croissance, inflation, politique ou événements géopolitiques.
La loi des grands nombres décrit le comportement de la moyenne d'un grand nombre de variables aléatoires indépendantes. Elle stipule qu'à mesure que le nombre d'essais augmente, la moyenne observée converge vers la valeur attendue de la distribution sous-jacente. En d'autres termes, plus une expérience est répétée, plus les résultats observés se rapprochent du résultat théorique.
Si l'on tire à pile ou face de façon répétée, la fréquence des piles se rapproche de 50 % à mesure que le nombre de lancers augmente. Sur 1 000 essais, il est extrêmement improbable d'obtenir un écart de type 55/45 dans un sens ou dans l'autre (0,17 %), alors que c'est tout à fait possible sur 100 lancers (36,8 %).
La loi des grands nombres aide à atténuer le risque lié aux fluctuations imprévisibles du marché. En investissant dans un portefeuille diversifié, on répartit le risque sur de nombreux actifs, ce qui réduit l'impact des mouvements individuels.
Elle est aussi utile pour analyser les données historiques. En examinant un grand nombre de configurations passées, les investisseurs peuvent identifier des schémas et des tendances. Par exemple, pour savoir si la Réserve fédérale a déjà baissé ses taux malgré une inflation supérieure à son objectif, on peut se tourner vers l'histoire pour repérer des précédents et leurs effets. Encore faut-il que l'échantillon soit assez grand pour tirer des conclusions fiables.
C'est le point essentiel pour le trader : un avantage statistique ne se vérifie que sur un grand nombre de transactions. Sur quelques trades, le hasard domine, et une série gagnante ou perdante ne prouve rien quant à la qualité réelle de la stratégie.
La loi des grands nombres et la signification statistique sont liées mais distinctes. La première concerne la convergence de la moyenne de l'échantillon vers l'espérance. La seconde mesure la probabilité que les résultats observés ne soient pas dus au hasard : un résultat est jugé statistiquement significatif si cette probabilité est inférieure à un seuil prédéfini, généralement 5 % ou moins.
En pratique, la loi des grands nombres soutient la signification statistique : avec un grand échantillon dont la moyenne est proche de l'espérance, les résultats sont moins susceptibles d'être le fruit du hasard. Attention toutefois : la signification statistique n'implique pas nécessairement une pertinence pratique ou économique. Pour décider, il faut comprendre les données, les méthodes statistiques et le contexte.
Le théorème de Bayes décrit comment actualiser des probabilités en fonction de nouvelles preuves. Il doit son nom au révérend Thomas Bayes, statisticien et théologien britannique du XVIIIe siècle. Il permet de calculer la probabilité d'une hypothèse à partir de connaissances antérieures (probabilité a priori) et de nouvelles preuves (vraisemblance). La probabilité actualisée est appelée probabilité a posteriori.
La formule est la suivante :
P(A|B) = P(B|A) × P(A) / P(B)
Où :
Le théorème de Bayes est précieux en trading, car il aide à mettre à jour ses croyances sur la probabilité d'événements à la lumière de nouvelles informations (résultats d'entreprise, indicateurs économiques). Son aspect essentiel : il actualise des croyances préalables, sans nécessairement tout recalculer de zéro.
Le problème de Linda (caissière de banque)
Un exemple célèbre vient des travaux de Kahneman et Tversky. Les participants recevaient l'information suivante :
Linda a 31 ans, elle est célibataire, a un franc-parler et est très intelligente. Elle a étudié la philosophie. Étudiante, elle était très préoccupée par les questions de discrimination et de justice sociale, et a participé à des manifestations antinucléaires.
On leur demandait ensuite de classer la probabilité de deux scénarios :
Bien que le premier scénario englobe le second (toutes les caissières incluent les caissières féministes), de nombreux participants ont jugé le second plus probable, car la description correspondait à leur stéréotype. C'est mathématiquement impossible : la probabilité conjointe de deux événements ne peut dépasser celle de l'un d'eux. Cet exemple illustre l'importance de vérifier ses hypothèses et de prendre en compte toute l'information disponible.
Steve est-il agriculteur ou bibliothécaire ?
Autre scénario des mêmes chercheurs : déterminer si Steve, décrit comme « un individu calme et timide qui aime lire et n'est pas très sociable », est plutôt agriculteur ou bibliothécaire. La plupart concluaient « bibliothécaire ». Or, en ajoutant l'information sur le nombre relatif d'agriculteurs et de bibliothécaires, la conclusion change. S'il y a 20 fois plus d'agriculteurs que de bibliothécaires et que 20 % des agriculteurs correspondent à ce profil, il reste 4 fois (20 × 0,20) plus probable que Steve soit agriculteur.
Cette étude souligne l'importance de mettre à l'épreuve ses hypothèses lorsque l'information est limitée, en se gardant des heuristiques trompeuses comme les stéréotypes. C'est exactement l'esprit de l'approche bayésienne : une mise à jour continue des croyances en fonction des nouvelles informations.
En trading comme en investissement, il faut toujours se demander : comment savez-vous que vous savez ?
Le théorème de Bayes n'est pas qu'une formule : il a donné naissance à toute une famille de méthodes statistiques, dites bayésiennes, très utilisées en finance quantitative. Leur principe est toujours le même : partir d'une croyance initiale (la distribution a priori), la confronter aux données observées (la vraisemblance) et en déduire une croyance révisée (la distribution a posteriori), qui servira à son tour d'a priori lorsque de nouvelles données arriveront.
Cette logique correspond bien à la réalité des marchés. Lorsqu'une entreprise publie ses résultats, les investisseurs ne repartent pas de zéro : ils corrigent l'opinion qu'ils avaient déjà de la société, de ses finances et de ses perspectives, et le cours s'ajuste en fonction de l'écart entre les chiffres publiés et les attentes.
L'approche fréquentiste interprète une probabilité comme la fréquence d'un événement sur un très grand nombre de répétitions. L'approche bayésienne y voit un degré de confiance dans une hypothèse, que l'on révise au fil des informations. En finance, où l'on ne peut pas « rejouer » mille fois la même année boursière, cette seconde lecture est souvent la plus naturelle.
Les deux approches ne s'opposent pas pour autant : le théorème de Bernstein-von Mises montre que, sous certaines conditions, la distribution a posteriori converge vers une loi normale centrée sur la vraie valeur du paramètre lorsque l'échantillon grandit. Autrement dit, avec beaucoup de données, l'a priori finit par peser très peu.
Supposons qu'avant toute analyse vous estimiez à 50 % la probabilité qu'un actif monte le mois prochain. Un signal apparaît ; votre historique montre qu'il était présent dans 70 % des mois haussiers, mais aussi dans 40 % des mois baissiers.
P(hausse | signal) = (0,70 × 0,50) / (0,70 × 0,50 + 0,40 × 0,50) = 0,35 / 0,55 ≈ 63,6 %
Le signal fait passer votre estimation de 50 % à environ 64 % : c'est un avantage réel, mais très loin d'une certitude. Raisonner ainsi évite de surréagir à un indicateur, ce qui est l'une des erreurs les plus fréquentes des traders.
| Principe | Ce qu'il dit | Lecture pour le trader |
|---|---|---|
| Règle de Cromwell | Ne jamais attribuer une probabilité de 0 ou de 1 à un événement, sauf s'il est logiquement certain ou impossible. | Avec un a priori de 0 ou de 1, aucune donnée ne peut plus vous faire changer d'avis. Gardez toujours une part de doute. |
| Principe d'indifférence | Sans information, on attribue la même probabilité à chaque issue. | Si vous n'avez étudié ni l'action A ni l'action B, rien ne justifie de parier sur l'une plutôt que sur l'autre. |
| Entropie maximale | Parmi les distributions compatibles avec ce que l'on sait, choisir celle qui suppose le moins de choses. | N'introduisez pas dans un modèle des certitudes que vous n'avez pas. |
| Cohérence (théorème de Cox) | Un ensemble de probabilités ne doit pas contenir de contradictions ; la mise à jour bayésienne découle de cette exigence. | Vos scénarios doivent sommer à 100 % et rester compatibles entre eux. |
| Intervalle crédible | Équivalent bayésien de l'intervalle de confiance : la plage dans laquelle le paramètre se situe avec une probabilité donnée. | Raisonnez en fourchettes (« entre 2 % et 9 % avec 90 % de probabilité ») plutôt qu'en chiffre unique. |
La règle de Cromwell mérite une attention particulière : l'excès de confiance est l'un des biais psychologiques les plus coûteux. C'est pourquoi les résultats futurs d'un actif ou d'un portefeuille se représentent sous forme de distribution, et non d'un chiffre unique :
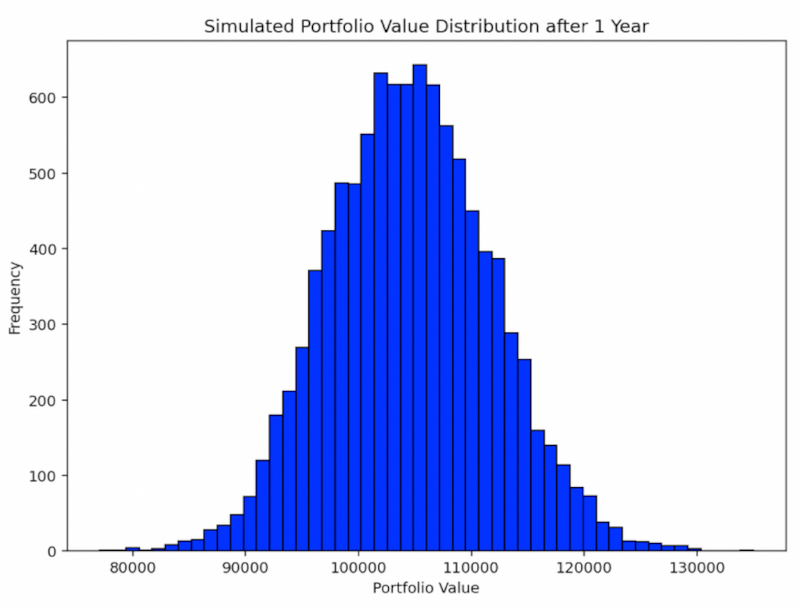
Un modèle bayésien se définit par deux ingrédients, l'a priori et la fonction de vraisemblance, dont on déduit l'a posteriori. Plusieurs choix structurent la démarche :
Dès que le modèle se complique, l'a posteriori ne se calcule plus à la main. On l'approche alors numériquement :
Enfin, un modèle se juge : le facteur de Bayes compare deux modèles concurrents, la moyenne de modèles combine leurs prévisions plutôt que d'en retenir un seul, et les vérifications prédictives a posteriori contrôlent que le modèle reproduit bien les données observées.
| Domaine | Apport de l'approche bayésienne |
|---|---|
| Construction de portefeuille | Combiner les opinions de l'investisseur avec les données historiques (c'est le principe du modèle de Black-Litterman), réviser l'allocation à mesure que les données arrivent et tenir compte de l'incertitude sur les rendements estimés. Voir aussi la parité des risques. |
| Valorisation | Estimer flux de trésorerie et taux d'actualisation sous forme de distributions ; valoriser des options réelles, où l'information se révèle par étapes ; évaluer une cible d'acquisition ou une start-up sans historique en combinant données de marché et avis d'experts. Voir mesurer la valeur d'une option. |
| Risque de marché | Mettre à jour en continu la distribution des rendements pour affiner la VaR et la CVaR (perte attendue au-delà de la VaR). |
| Risque de crédit | Estimer des probabilités de défaut lorsque les défauts observés sont rares, en s'appuyant sur des connaissances préalables. |
| Risque opérationnel et de liquidité | Combiner données internes, données externes et jugement d'experts ; les réseaux bayésiens modélisent les dépendances entre facteurs pouvant mener à une crise de liquidité. |
| Tests de résistance | Construire des scénarios de crise et les réviser selon les conditions de marché du moment. |
L'inférence variationnelle remplace l'échantillonnage du MCMC par un problème d'optimisation : on cherche, dans une famille de distributions simples, celle qui se rapproche le plus du véritable a posteriori. Concrètement, on maximise une quantité appelée ELBO (evidence lower bound, borne inférieure de la vraisemblance marginale).
Le résultat est moins exact que celui d'un MCMC, et tend notamment à sous-estimer l'incertitude, mais il est beaucoup plus rapide. C'est ce qui rend ces méthodes intéressantes pour les grands portefeuilles, les modèles à nombreux facteurs latents, les séries temporelles (modèles espace-état), les modèles macroéconomiques de type DSGE, les réseaux de neurones bayésiens et le trading algorithmique, où un modèle doit être recalculé en quasi temps réel.
Un modèle paramétrique impose une forme à l'avance, par exemple une loi normale. Les méthodes non paramétriques laissent la complexité du modèle s'adapter aux données, ce qui convient aux rendements financiers, dont les distributions sont asymétriques et à queues épaisses.
Ces méthodes sont aussi utiles pour les actifs peu liquides (immobilier, certaines obligations), dont les données sont rares. Leur contrepartie est un coût de calcul élevé et un risque de surapprentissage si l'échantillon est trop court.
L'exemple suivant illustre la démarche sur trois actifs et des données synthétiques : on part d'un a priori sur le rendement mensuel attendu, on le met à jour avec 60 mois d'observations, puis on optimise le portefeuille avec les rendements a posteriori. Avec un a priori normal conjugué, la moyenne a posteriori est une moyenne pondérée de l'a priori et de la moyenne observée, chacun pesant selon sa précision (l'inverse de sa variance) :
μpost = (μ0 / τ0² + n × x̄ / σ²) / (1 / τ0² + n / σ²)
import numpy as np
from scipy.optimize import minimize

# 1. Rendements mensuels synthétiques pour 3 actifs (5 ans de données)
rng = np.random.default_rng(42)
vraies_moyennes = np.array([0.004, 0.007, 0.010])
vols = np.array([0.03, 0.05, 0.08])
n_obs = 60
rendements = rng.normal(vraies_moyennes, vols, size=(n_obs, 3))

# 2. A priori : rendement mensuel attendu de 0,5 % pour chaque actif,
#    avec une incertitude (écart type) de 0,5 %
mu_prior = np.full(3, 0.005)
tau_prior = np.full(3, 0.005)

# 3. Mise à jour bayésienne (a priori normal conjugué, variance connue)
moyenne_obs = rendements.mean(axis=0)
sigma = rendements.std(axis=0, ddof=1)
precision_prior = 1 / tau_prior**2
precision_data = n_obs / sigma**2
mu_post = (precision_prior * mu_prior + precision_data * moyenne_obs) / (precision_prior + precision_data)
tau_post = np.sqrt(1 / (precision_prior + precision_data))

# 4. Optimisation moyenne-variance avec les rendements a posteriori
cov = np.cov(rendements, rowvar=False)
aversion = 5  # aversion au risque

def objectif(w):
    return -(w @ mu_post - 0.5 * aversion * w @ cov @ w)

contraintes = {'type': 'eq', 'fun': lambda w: w.sum() - 1}
bornes = [(0, 1)] * 3
res = minimize(objectif, np.full(3, 1/3), method='SLSQP', bounds=bornes, constraints=contraintes)

print("Moyennes observées  :", moyenne_obs.round(4))
print("Moyennes a posteriori:", mu_post.round(4))
print("Incertitude a posteriori:", tau_post.round(4))
print("Poids optimaux      :", res.x.round(3))
Résultat obtenu :
| Actif 1 | Actif 2 | Actif 3 | |
|---|---|---|---|
| A priori | 0,50 % | 0,50 % | 0,50 % |
| Moyenne observée | 0,34 % | 0,08 % | 0,80 % |
| Moyenne a posteriori | 0,39 % | 0,33 % | 0,58 % |
| Poids optimal | 70,2 % | 8,9 % | 20,9 % |
Deux enseignements se dégagent. D'abord, les estimations sont ramenées vers l'a priori, et d'autant plus que l'actif est volatil : la moyenne de l'actif 3, la plus bruitée, passe de 0,80 % à 0,58 %, tandis que celle de l'actif 1 bouge peu. Cinq ans de données ne suffisent pas à connaître précisément un rendement moyen, et le calcul bayésien en tient compte. Ensuite, l'allocation qui en découle est moins extrême que celle obtenue avec les moyennes brutes, ce qui la rend moins sensible aux erreurs d'estimation.
Limites des méthodes bayésiennes
Le résultat dépend de l'a priori : sur un échantillon court, deux analystes aux convictions différentes aboutiront à des conclusions différentes. Les modèles élaborés sont coûteux en calcul et difficiles à valider. Enfin, une méthode bayésienne quantifie l'incertitude à l'intérieur d'un modèle, mais ne protège pas contre un modèle mal spécifié ni contre un changement de régime de marché. Cet exemple est pédagogique et ne constitue pas un conseil en investissement.
La corrélation et la covariance décrivent la relation entre deux variables aléatoires. La covariance mesure dans quelle mesure elles évoluent ensemble ; la corrélation mesure la force et la direction de cette relation.
Une covariance positive indique que les deux variables tendent à évoluer dans le même sens, une covariance négative dans des sens opposés. Le coefficient de corrélation varie de -1 à 1 : 1 indique une corrélation positive parfaite, -1 une corrélation négative parfaite, et 0 une absence de corrélation linéaire.
En trading, ce sont des outils utiles pour la gestion du risque et la diversification. En comprenant la relation entre actifs, un investisseur peut sélectionner des actifs peu corrélés afin de réduire le risque global du portefeuille. Un portefeuille d'actions fortement corrélées est en effet plus risqué qu'un portefeuille d'actifs faiblement corrélés. En diversifiant ainsi, on crée un portefeuille plus résilient, moins exposé à des pertes importantes lors d'une baisse du marché.
Il faut toutefois garder à l'esprit que les corrélations sont rétrospectives et évoluent dans le temps. Par exemple, actions et obligations peuvent être négativement corrélées lorsque l'inflation diminue, mais positivement corrélées lorsqu'elle augmente.
Les interprétations les plus robustes examinent donc l'état intrinsèque des actifs sur la base des liens économiques de cause à effet, plutôt que de simples coefficients de corrélation, qui ne sont que les sous-produits fugaces de l'environnement dans lequel ils ont été mesurés.
Connaître la probabilité d'un résultat ne suffit pas : encore faut-il décider quelle fraction de son capital engager. C'est précisément ce que résout le critère de Kelly, formule développée par John L. Kelly Jr. en 1956, aujourd'hui appliquée au trading, à l'investissement et à la gestion du risque.
Le critère de Kelly détermine la taille de mise qui maximise le taux de croissance du capital à long terme. Une formulation courante adaptée au trading est :
Kelly % = (p × b − q) / b
Où p est la probabilité de gain, q = 1 − p la probabilité de perte, et b le ratio gain/perte. Lorsque le résultat est négatif, l'avantage est défavorable et il n'y a aucun intérêt à investir.
Sa grande force est qu'il intègre intrinsèquement le risque de ruine : il ajuste la mise pour éviter les pertes catastrophiques tout en profitant de la capitalisation. Sa principale limite tient au fait qu'il exige des probabilités précises, rarement connues dans le monde réel.
Kelly fractionnaire : la prudence des professionnels
Le Kelly complet maximise la croissance mais génère une volatilité très élevée et des drawdowns sévères. Comme les probabilités réelles sont incertaines, la plupart des traders n'appliquent qu'un Kelly fractionnaire (25 à 50 % de la valeur calculée). On capture ainsi l'essentiel du potentiel de croissance tout en réduisant fortement la variance et le risque de ruine. À l'inverse, miser au-delà de Kelly (overbetting) conduit mathématiquement à la ruine, même avec un avantage positif.
En pratique, le critère de Kelly relie directement les concepts vus plus haut : il transforme une espérance positive et une probabilité estimée en une taille de position concrète, en gardant la survie du capital au centre de la décision.
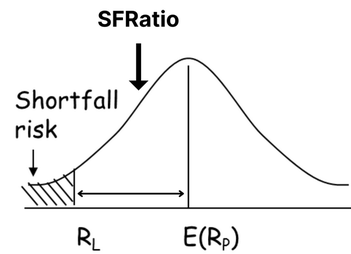
Si le critère de Kelly répond à la question « combien miser ? », le critère Safety-First de Roy répond à une autre question, tout aussi vitale : « quel portefeuille minimise le risque de catastrophe ? ». Formulé par l'économiste britannique A.D. Roy dans son article Safety First and the Holding of Assets (Econometrica, 1952), c'est une approche de sélection de portefeuille entièrement tournée vers la préservation du capital.
Détail historique remarquable : Roy publie son article environ trois mois après le célèbre Portfolio Selection de Harry Markowitz, la même année et de façon totalement indépendante, en développant lui aussi l'arbitrage moyenne-variance. Markowitz recevra le prix Nobel d'économie en 1990, mais reconnaîtra plus tard que Roy pouvait revendiquer une part égale de la paternité de la théorie moderne du portefeuille. On surnomme d'ailleurs Roy le « père oublié » de la théorie moderne du portefeuille. Sa grande originalité par rapport à Markowitz : au lieu de considérer les deux côtés de la distribution des rendements, il se concentre uniquement sur l'extrémité gauche, c'est-à-dire sur le risque de baisse — inaugurant ainsi l'étude du downside risk. La Value-at-Risk (VaR), omniprésente dans la gestion des risques actuelle, en descend directement.
L'idée centrale est de choisir l'actif ou le portefeuille qui minimise la probabilité que le rendement passe sous un seuil critique, appelé niveau de catastrophe (ou seuil de rendement). Pour un investisseur averse au risque, l'objectif n'est plus de maximiser le rendement moyen, mais de garantir que la probabilité de tomber sous ce seuil soit la plus faible possible.
Le critère repose sur le Safety-First Ratio (SFRatio), qui rapporte l'excédent de rendement attendu au-dessus du seuil à la volatilité du portefeuille :
SFRatio = [E(Rp) − R] / σ
| Élément | Signification |
|---|---|
| E(Rp) | Rendement attendu du portefeuille |
| R | Seuil de rendement (niveau de catastrophe) |
| σ | Écart type du rendement du portefeuille |
En pratique, on retient le portefeuille qui maximise le SFRatio. Sous l'hypothèse de rendements normalement distribués, maximiser ce ratio revient à minimiser la probabilité de passer sous le seuil. On remarquera au passage la parenté formelle avec le ratio de Sharpe : lorsque le seuil R correspond au taux sans risque, le SFRatio et le ratio de Sharpe coïncident. Roy avait donc décrit dès 1952 une mesure que Sharpe popularisera bien plus tard.
Le choix du niveau de catastrophe est en partie subjectif et doit refléter la situation de chacun. Il peut être fixé de deux manières principales :
À manier avec précaution
Malgré ces limites, le critère de Roy conserve une valeur pédagogique et pratique forte : il incarne, avant l'heure, la philosophie qui traverse tout cet article, la préservation du capital passe avant la maximisation du gain moyen. C'est le même esprit « sécurité d'abord » que l'on retrouve dans le critère de Kelly et dans la simulation de Monte-Carlo, présentée ci-dessous.
Un backtest classique ne montre qu'une seule séquence historique de transactions. Or l'ordre dans lequel les gains et les pertes surviennent change radicalement l'expérience vécue : dix pertes consécutives en début de période n'ont pas le même effet que ces mêmes pertes dispersées entre des gains. C'est là qu'intervient la simulation de Monte-Carlo.
Le principe consiste à réordonner aléatoirement, des milliers de fois, la séquence des transactions d'une stratégie afin d'obtenir, non pas un résultat unique, mais une distribution complète des résultats possibles. On obtient le fameux « graphique spaghetti » de milliers de courbes de capital.
Cette approche apporte des informations qu'un backtest standard ne peut pas fournir :
Espérance positive n'égale pas survie garantie
Un avantage statistique ne garantit le profit que sur le long terme ; il ne garantit en rien la survie à court terme. La variance des résultats peut anéantir un compte si la taille des positions est trop élevée, avant même que l'avantage n'ait eu le temps de s'exprimer. C'est précisément pour cela que l'on combine le critère de Kelly (pour dimensionner), le critère de Roy (pour fixer un seuil de catastrophe) et la simulation de Monte-Carlo (pour stress-tester).
La plupart des plateformes de backtesting intègrent désormais un module de Monte-Carlo, mais on peut aussi en réaliser une version simple avec Excel ou, pour des cas plus complexes, avec Python ou R. L'essentiel reste de garder son bon sens : les marchés ne sont pas stationnaires, et aucune simulation ne remplace une compréhension des liens économiques sous-jacents.
Pour aller plus loin sur la mesure de l'incertitude elle-même, consultez notre guide sur l'entropie de Shannon appliquée au trading, qui montre comment distinguer un avantage réel d'un simple ajustement au bruit.
La théorie des probabilités joue un rôle central dans le trading : elle aide à prendre des décisions éclairées sur la base d'une analyse fondée sur des données plutôt que sur l'intuition. En l'utilisant, les traders estiment la probabilité des mouvements de marché, évaluent le rapport risque-récompense d'une transaction, gèrent leur portefeuille et optimisent le dimensionnement de leurs positions.
Au fil de cet article, une idée revient comme un fil conducteur : tout est distribution, jamais certitude. De l'espérance de gain à la loi des grands nombres, du théorème de Bayes et des méthodes bayésiennes au critère de Kelly, du critère Safety-First de Roy à la simulation de Monte-Carlo, ces outils convergent vers un même objectif : transformer l'incertitude en avantage exploitable, tout en protégeant le capital contre le risque de ruine. Face à des statistiques aussi sévères que celles de l'AMF, cette discipline probabiliste n'est pas un luxe académique : c'est la condition première de la survie sur les marchés.
| # | Broker | Note | Réglementation | Plateformes | Actions |
|---|---|---|---|---|---|
| 1 |  | ★★★★★ 4.6/5 | ASICCBFSAIFRSABVIFSCFSCAJFSAOCRISFCCMA | MetaTrader 4 & 5, AvaOptions | |
| 2 |  | ★★★★★ 4.6/5 | CySECKNFFCAFSCDFSA | xStation | |
| 3 |  | ★★★★ 4.5/5 | FCABaFinASICFINMAMASCFTC | IG, ProRealTime, MT4, TradingView | |
| 4 |  | ★★★★ 4.3/5 | CySECFCAASICFSASADGM | eToro | |
| 5 |  | ★★★★ 4.3/5 | CMVMFCASCBBACENFSCM | MT4 & 5, ActivTrader, TradingView |
ADGM : Abu Dhabi • ASIC : Australie • BaFin : Allemagne • BVIFSC : Îles Vierges britanniques • BACEN : Brésil • CMA : Kenya • CySEC : Chypre • CMVM : Portugal • CFTC : USA • CBFSAI : Irlande • DFSA : Dubaï • FSCM : Île Maurice • FCA : Royaume-Uni • FINMA : Suisse • FRSA : Abu Dhabi • FSAS : Seychelles • FSCA : Afrique du Sud • JFSA : Japon • KNF : Pologne • MAS : Singapour • OCRI : Canada • SCB : Bahamas • SFC : Colombie
⚠️ Le trading de CFD implique un risque de perte. 69 à 80 % des comptes d'investisseurs particuliers perdent de l'argent en négociant des CFD.