Mis à jour le 6 octobre 2026 par l'Équipe de broker-forex.fr
Les marchés financiers ne se comportent pas de la même manière en permanence : des phases calmes et haussières alternent avec des périodes de stress où la volatilité explose. Le problème est que personne ne sonne la cloche lors du passage de l'une à l'autre. Les modèles de Markov cachés (MMC, ou HMM pour Hidden Markov Models) ont précisément été conçus pour estimer un état que l'on ne voit pas à partir de données que l'on voit.
Issus de la reconnaissance vocale et de la bio-informatique, ils sont utilisés en finance quantitative pour identifier les régimes de marché et adapter en conséquence les stratégies de trading, la gestion du risque et l'allocation d'actifs. Ce guide explique leur fonctionnement, donne un exemple chiffré et détaille leurs applications comme leurs limites.
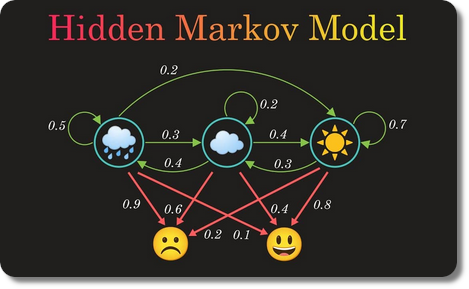
Un modèle de Markov caché, ou MMC (en anglais Hidden Markov Model, HMM), est un modèle statistique qui décrit un système passant d'un état à un autre au fil du temps, sans que ces états soient directement visibles. On n'observe que leurs conséquences : des données « émises » par l'état en cours.
L'image classique est celle de la météo. Imaginez une personne enfermée dans une pièce sans fenêtre : elle ne voit pas le temps qu'il fait (l'état caché : pluie, nuages ou soleil), mais elle voit l'humeur des gens qui entrent (l'observation). Jour après jour, elle peut en déduire le temps probable à l'extérieur, et même anticiper celui du lendemain si elle sait que le beau temps a tendance à durer.
En finance, le raisonnement est le même. Personne n'affiche à l'écran « le marché est en régime de crise » : le régime de marché est l'état caché. Ce que l'on observe, ce sont les rendements, la volatilité, les volumes ou les écarts de taux. Le modèle remonte de ces observations vers le régime le plus probable.
Chaîne de Markov ou modèle de Markov caché ? Dans une chaîne de Markov simple, l'état est observé directement (par exemple « séance en hausse » ou « séance en baisse »). Dans un modèle de Markov caché, l'état est invisible et doit être estimé à partir de données bruitées. Dans les deux cas s'applique la propriété de Markov : l'état de demain ne dépend que de l'état d'aujourd'hui, pas de tout l'historique.
Les fondations sont posées par le mathématicien russe Andreï Markov, qui étudie au début du XXe siècle les suites d'événements dont chaque terme ne dépend que du précédent. Les modèles « cachés » apparaissent dans les années 1960 aux États-Unis, avec les travaux de Leonard Baum et de ses collègues, qui mettent au point la méthode d'estimation encore utilisée aujourd'hui.
| Date | Auteur | Contribution |
|---|---|---|
| 1906-1913 | Andreï Markov | Théorie des chaînes qui portent son nom |
| Années 1960 | Leonard Baum et coauteurs | Formalisation des modèles de Markov cachés et de leur estimation (algorithme de Baum-Welch) |
| 1967 | Andrew Viterbi | Algorithme de décodage de la séquence d'états la plus probable |
| Années 1970-1980 | Recherche en reconnaissance vocale | Premières applications industrielles à grande échelle |
| 1989 | James Hamilton | Modèle à changement de régime markovien appliqué aux cycles économiques américains |
C'est l'article de James Hamilton, publié en 1989 dans la revue Econometrica, qui installe durablement ces outils en économie et en finance : il montre que la croissance américaine alterne entre deux régimes, expansion et récession, dont on peut estimer la probabilité à chaque date. Depuis, les modèles à changement de régime sont utilisés pour l'étude des cycles, des taux de change, de la volatilité des actions et de l'allocation d'actifs.
Un modèle de Markov caché est entièrement défini par cinq éléments.
| Composante | Définition | Exemple sur un marché actions |
|---|---|---|
| États cachés | Les situations possibles du système, non observables | Régime calme, régime turbulent |
| Observations | Les données visibles produites par l'état en cours | Rendement quotidien de l'indice |
| Probabilités de transition | Probabilité de passer d'un état à un autre entre deux dates | 95 % de chances de rester en régime calme le lendemain |
| Probabilités d'émission | Loi des observations dans chaque état | Rendements peu dispersés en régime calme, très dispersés en régime turbulent |
| Probabilités initiales | Probabilité de se trouver dans chaque état au départ | 67 % calme, 33 % turbulent |
Les probabilités de transition sont rangées dans une matrice de transition, dont chaque ligne totalise 100 %. Les valeurs situées sur la diagonale mesurent la persistance des régimes : plus elles sont proches de 100 %, plus un régime dure longtemps une fois installé.
Sur les marchés, les émissions sont le plus souvent modélisées par une loi normale propre à chaque régime (moyenne et écart-type différents). L'ensemble produit un mélange de lois normales, capable de reproduire les queues épaisses et les grappes de volatilité que le modèle brownien classique, à volatilité constante, ne sait pas représenter.
L'utilisation d'un HMM revient à résoudre trois problèmes, chacun associé à un algorithme.
| Problème | Question posée | Algorithme |
|---|---|---|
| Évaluation | Quelle est la vraisemblance d'une séquence d'observations, les paramètres étant connus ? | Algorithme forward (avant) |
| Décodage | Quelle est la séquence d'états cachés la plus probable ? | Algorithme de Viterbi |
| Apprentissage | Quels paramètres rendent les observations les plus vraisemblables ? | Algorithme de Baum-Welch (espérance-maximisation) |
Pour le trader, une distinction pratique est essentielle :
Piège classique : un backtest construit sur des régimes lissés ou décodés sur tout l'historique « connaît l'avenir ». Ses performances sont illusoires. Un test honnête n'utilise que les probabilités filtrées, avec un modèle réestimé uniquement sur les données passées.
Prenons un modèle simplifié à deux régimes pour un indice actions, observé en données quotidiennes. Les paramètres ci-dessous sont illustratifs : ils ne proviennent pas d'une estimation sur un marché précis.
| Paramètre | Régime calme | Régime turbulent |
|---|---|---|
| Rendement quotidien moyen | +0,05 % | −0,10 % |
| Écart-type quotidien | 0,70 % | 2,00 % |
| Probabilité de rester dans le régime le lendemain | 95 % | 90 % |
| Probabilité de changer de régime | 5 % | 10 % |
Durée moyenne des régimes. Elle vaut 1 / (1 − persistance). Le régime calme dure en moyenne 1 / 0,05 = 20 séances, le régime turbulent 1 / 0,10 = 10 séances.
Répartition à long terme. La part du temps passée en régime calme vaut 0,10 / (0,05 + 0,10) = 66,7 %, contre 33,3 % en régime turbulent.
Mise à jour après une séance. Supposons que le modèle attribuait hier 90 % de probabilité au régime calme, et que l'indice perde aujourd'hui 2,5 %.
| Étape | Calcul | Résultat |
|---|---|---|
| Prévision du régime calme avant la séance | 0,90 × 0,95 + 0,10 × 0,10 | 86,5 % |
| Prévision du régime turbulent avant la séance | 1 − 0,865 | 13,5 % |
| Densité d'un rendement de −2,5 % en régime calme | Loi normale (0,05 % ; 0,70 %) | 0,00075 |
| Densité d'un rendement de −2,5 % en régime turbulent | Loi normale (−0,10 % ; 2,00 %) | 0,0971 |
| Probabilité du régime turbulent après la séance | 0,135 × 0,0971 / (0,135 × 0,0971 + 0,865 × 0,00075) | ≈ 95,3 % |
Une seule séance très inhabituelle pour un marché calme (plus de 3,6 écarts-types) suffit à faire passer la probabilité du régime turbulent de 13,5 % à plus de 95 %. Comme ce régime est persistant, le modèle anticipe encore environ 86 % de chances d'y être le lendemain. C'est exactement le type d'information qu'un trader peut utiliser pour réduire son levier ou la taille de ses positions.
Les HMM sont nés hors de la finance : ils ont longtemps été la technologie de référence de la reconnaissance vocale (les sons sont les observations, les mots les états cachés) et restent très utilisés en bio-informatique pour la recherche de gènes et l'analyse de protéines. Sur les marchés, leurs usages se concentrent autour de la notion de régime.
C'est l'application principale : distinguer marché haussier, baissier ou sans tendance, ou encore volatilité faible et volatilité élevée. Chaque régime correspond à un comportement distinct de l'actif. Un trader qui applique une stratégie de suivi de tendance (ou momentum), fondée sur l'idée que le mouvement récent se prolonge, peut ainsi n'activer sa stratégie que lorsque le modèle identifie un régime directionnel et la mettre en veille en régime latéral.
Plutôt que de générer directement des signaux d'achat et de vente, le HMM sert souvent de filtre placé au-dessus d'un système de trading existant : exposition pleine en régime favorable, exposition réduite, couverture ou position vendeuse en régime défavorable.
Les volatilités et les corrélations ne sont pas stables : elles augmentent brutalement en période de stress. En estimant un jeu de paramètres par régime, le modèle fournit une vision plus nuancée de la contribution de chaque actif au risque du portefeuille, et des mesures comme la VaR et la CVaR conditionnelles au régime en cours.
Une fois les régimes identifiés, l'allocation peut être ajustée. Dans un portefeuille construit en parité des risques, un régime de forte volatilité conduira par exemple à renforcer les actifs défensifs, comme les obligations d'État à court terme, et à alléger les actifs risqués.
Connaître le comportement de chaque classe d'actifs selon le régime aide à vérifier qu'un portefeuille reste équilibré dans plusieurs environnements, et pas seulement dans celui qui a dominé la période récente. Voir aussi notre guide sur la répartition des actifs et la diversification.
La mise en œuvre ne demande pas de programmer les algorithmes soi-même : des bibliothèques libres existent en Python (hmmlearn, statsmodels pour les modèles à changement de régime) et en R. La difficulté est méthodologique.
Utilisez des séries stationnaires : rendements logarithmiques plutôt que prix, éventuellement complétés par la volatilité réalisée, les volumes ou un indicateur de stress. Évitez d'empiler des variables redondantes.
Commencez par deux régimes, éventuellement trois. Les critères d'information (AIC, BIC) aident à comparer les versions, mais un modèle qui a besoin de cinq ou six états pour « coller » aux données est le plus souvent surajusté.
L'algorithme de Baum-Welch converge vers un optimum local : relancez l'estimation avec plusieurs initialisations aléatoires et conservez la solution la plus vraisemblable.
Les états sont numérotés arbitrairement par le logiciel. Examinez la moyenne, la volatilité et la persistance de chacun pour leur donner un sens économique. Un régime qui ne dure qu'une ou deux séances n'est pas exploitable.
Réestimez le modèle sur fenêtre glissante et n'utilisez que les probabilités filtrées. Comparez le résultat à une règle simple, par exemple un filtre de volatilité, pour vérifier que la complexité apporte quelque chose.
Définissez à l'avance ce que chaque régime implique : niveau d'exposition, levier, type de stratégie active. Complétez par des tests de robustesse, par exemple une simulation de Monte-Carlo.
Plusieurs de ces limites méritent d'être précisées.
Pour dépasser ces limites, la recherche a proposé plusieurs variantes.
| Modèle | Ce qu'il ajoute |
|---|---|
| Modèle à changement de régime markovien (Hamilton) | Une dynamique autorégressive des observations à l'intérieur de chaque régime |
| Modèles GARCH à changement de régime | Une volatilité qui varie aussi au sein de chaque régime |
| Modèles semi-markoviens cachés | Une loi explicite pour la durée des régimes |
| HMM à probabilités de transition variables | Des transitions qui dépendent de variables économiques (taux, spreads de crédit, etc.) |
| HMM à émissions par mélange de gaussiennes | Des distributions plus souples dans chaque état |
| Filtre de Kalman | Le cas voisin où l'état caché est continu et non discret |
Les réseaux de neurones ont remplacé les HMM en reconnaissance vocale, et ils sont de plus en plus testés sur les données financières (voir notre dossier sur l'IA dans le trading). En finance, où les données sont peu nombreuses et très bruitées, la sobriété et la lisibilité des modèles de Markov cachés restent toutefois un avantage réel.
Même sans estimer soi-même un modèle, l'approche par régimes apporte plusieurs enseignements pratiques.
Rappel : un modèle statistique ne supprime pas le risque de perte, en particulier sur les produits à effet de levier. Selon l'étude de l'AMF menée sur quatre ans, plus de 89 % des clients particuliers actifs sur les CFD et le Forex sont perdants.
Les modèles de Markov cachés partent d'une idée simple : les marchés traversent des phases différentes, que l'on ne voit pas directement mais que les prix trahissent. En associant à chaque phase sa propre loi de rendement et une probabilité de transition, ils transforment cette intuition en un outil mesurable, utile pour filtrer une stratégie, ajuster une exposition ou piloter une allocation.
Leur intérêt tient autant à ce qu'ils disent qu'à ce qu'ils ne promettent pas. Un HMM ne prédit pas le prochain mouvement de cours ; il estime, avec retard et incertitude, l'environnement dans lequel on se trouve. Utilisé avec peu d'états, testé hors échantillon et relié à des règles de gestion définies à l'avance, il constitue un complément solide à l'analyse classique. Utilisé comme une boîte noire, il n'ajoute qu'une couche de complexité.
